从开店资料到企业知识系统:知识组织、RAG 与业务流程如何协同
延续开店资料审核场景,拆解 OCR、知识图谱、混合检索、RAG、上下文与记忆、权限和工作流如何协同,将企业文件转化为带证据、可执行、可追踪的材料准备清单。
OpenSay Tech Knowledge Base · Issue 008 · 2026-11-11 · 约 15 分钟 · 企业知识系统 · 技术方案
作者:Mia · 直说科技 OpenSay Tech · 企业知识系统
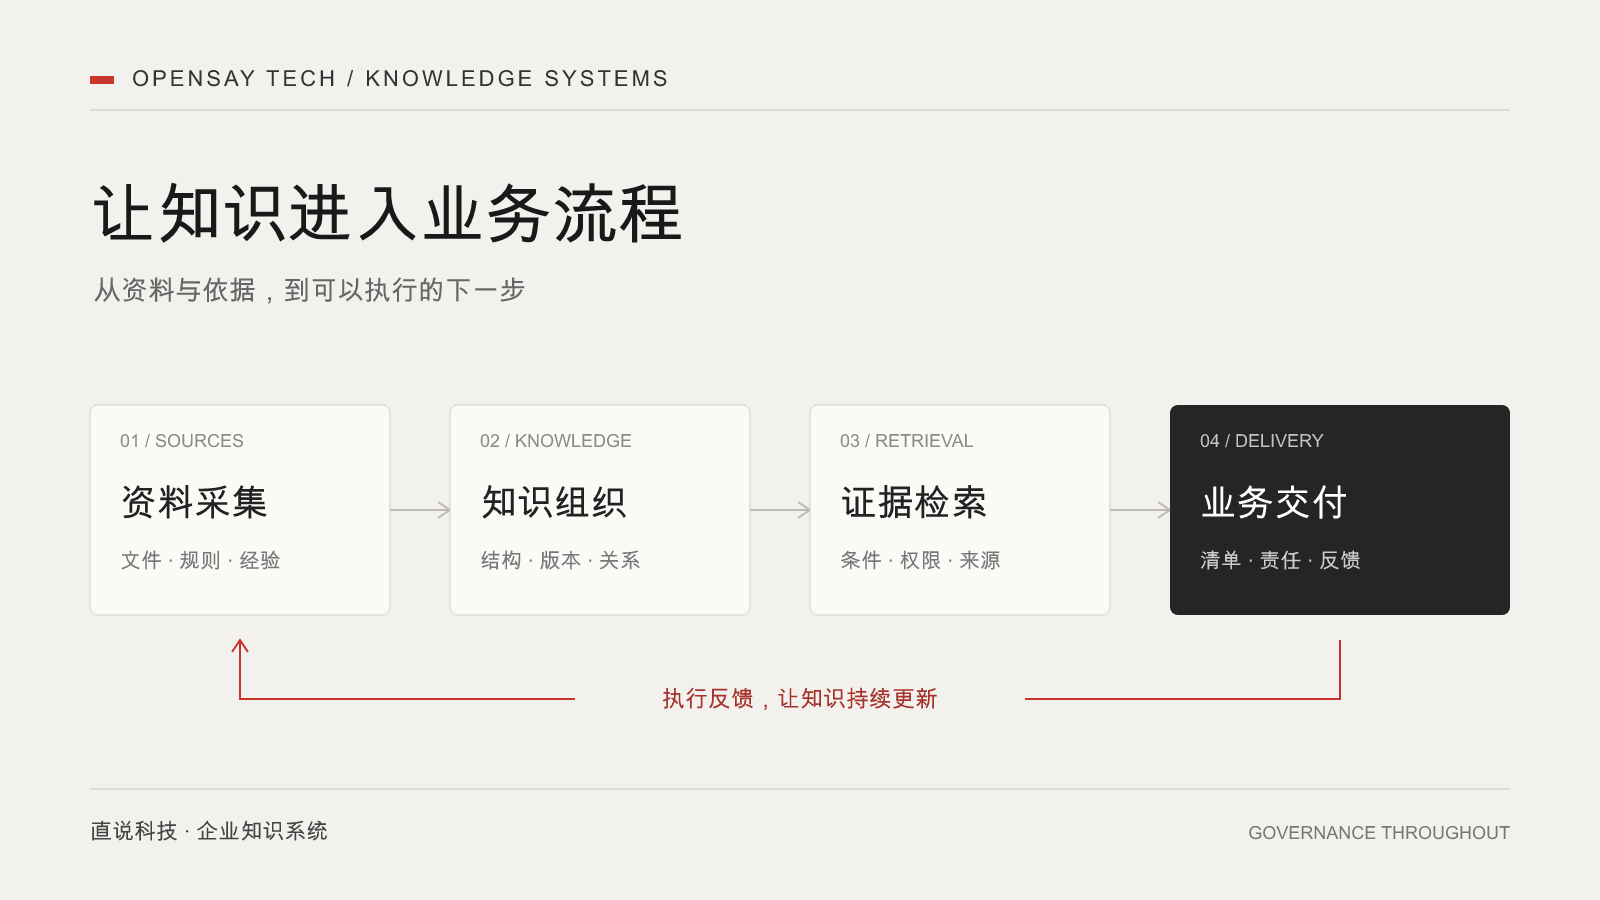
以一项完整业务任务组织知识系统
运营准备开店资料,法务提供的文件与历史提交版本名称不同,双方需要重新确认材料能否使用。上一篇分析了这一场景背后的知识管理问题:文件被保存下来,适用条件与判断依据却没有完整进入交接。
进入技术建设阶段,系统需要完成一条明确的处理链:识别申请条件,找到当前适用的要求,关联候选文件,列出材料缺项和待确认事项,再把处理结果交给相应岗位。最终交付物是一份带来源、版本和责任人的材料准备清单。
围绕这一任务,可以构建一个覆盖采集、组织、检索、应用与更新的企业知识系统,责任、权限和审核机制贯穿全程。文档库负责保留原件,知识组织建立业务关系,检索与模型负责形成有依据的建议,流程服务负责推进任务,执行记录则为下一次办理积累经验。
平台要求、企业文件、经办经验、历史反馈
                  ↓ 采集与核验
        原件库+业务对象+知识片段
                  ↓ 组织与索引
       条件识别 → 权限与版本过滤
                  ↓ 检索与判断
       证据集合 → 材料清单与待确认项
                  ↓ 业务应用
       岗位确认 → 实际提交 → 平台反馈
                  ↓ 更新回流
       修订知识、规则、索引及任务状态

治理贯穿:来源、责任、审核、权限、版本、审计
这套系统的边界同样具体:帮助团队准备、确认和追踪材料。平台是否接受申请,以实际反馈为准。每次办理都应留下采用了哪些要求、使用了哪个文件版本、由谁确认以及收到什么结果。
文档治理:让文件具备可检索的业务身份
平台说明、公司文件和历史反馈,可能分别存在于网页、PDF、扫描件和邮件中。接入层首先需要保留原件、来源地址、获取时间和访问权限,为后续处理建立统一的文档标识 document_id。
扫描件通过 OCR(光学字符识别) 提取文字;Layout Parsing(版面解析) 识别标题、正文、表格、脚注及页码位置。对于“材料名称—适用主体—格式要求”这类表格,列与列之间的关系必须保留。否则,系统虽然读到了文字,却可能把不同主体的要求拼在一起。
解析后的内容进入 Chunking(分块)。在这个案例中,适合按一条完整要求及其适用条件组织知识片段,而不是机械地每隔固定字数截断。片段保留 chunk_id、所属文档、章节路径和原文位置;检索命中具体条款时,可以通过 Parent–Child Retrieval(父子块检索) 补回所属小节,避免遗漏同节中的例外条件。补回的内容仍需经过权限核验。
这些文字还需要配上 Metadata(元数据)。元数据决定“这条知识属于谁、什么时候有效、适用于什么任务”,是业务筛选的基础。
| 元数据字段 | 在开店场景中的含义 | 系统用途 |
|---|---|---|
| platform / market | 平台与市场 | 排除其他平台、地区的要求 |
| entity_type / business_scope | 主体类型与业务范围 | 匹配本次申请条件 |
| version / effective_from / effective_to | 版本与有效期 | 判断规则在任务日期是否适用 |
| review_status / reviewer | 审核状态与确认人 | 区分待核验资料与已确认规则 |
| source_uri / page / section | 来源与原文位置 | 支持逐项引用与复核 |
| tenant_id / access_policy_id | 企业标识与访问策略 | 限定可检索范围 |
| content_hash | 内容指纹 | 识别重复文件及内容变化 |
这里需要区分“上传时间”和“生效时间”。今天上传的文件可能是旧版本,昨天发布的要求也可能下个月才生效。只按最新上传时间排序,无法判断当前应该使用哪份资料。
知识组织:把文件、规则与申请连接起来
元数据描述单份资料,业务办理还需要组织对象之间的关系。在这个场景中,可以先定义平台、申请主体、材料要求、证明文件、申请单和反馈记录六类对象,并明确各自属性与关系。这对应 Ontology(本体):约定系统中有哪些对象、如何区分、可以建立哪些联系。
例如,一项材料要求“适用于”某类申请主体,一份证明文件“用于满足”某项要求,一次申请“采用”某个文件版本,一条平台反馈“对应”一次提交。这里尤其需要区分“企业提供过某份文件”与“平台在某次申请中接受过该文件”,两者不能自动等同。
将具体对象及关系填入模型,就形成了可查询的关系数据;采用图结构管理时,可进一步形成 Knowledge Graph(知识图谱)。一期关系较少,可以用关系数据库中的对象表与关联表实现,不必先建设独立图数据库。
如果业务问题进一步变成“主体变化后,哪些授权、证明和未完成申请受到影响”,系统就需要沿关系查找。GraphRAG 可以利用图关系组织证据,再交给模型解释影响范围。它适合关系查询已经成为主要需求的场景,不能替代原始条款与实际反馈。这里使用图增强检索的一般含义;Microsoft GraphRAG 则提供了具体的图索引与查询实现。技术参考
文档检索与关系查询由此承担不同任务:前者寻找要求的具体表述,后者确认要求、文件和申请之间如何连接。只有这种分工清晰,技术选型才有业务依据。
检索设计:先确定适用范围,再寻找相关证据
当运营输入“这份公司资料能不能用于开店”,系统首先进行 Query Understanding(查询理解),提取平台、市场、主体类型和申请日期。关键字段缺失时,进入 Slot Filling(槽位补全),通过追问补齐任务条件。
用户身份由登录系统确认,组织归属与权限由服务端读取。不能让用户在提问中自行声明“我是管理员”,再据此扩大搜索范围。
随后执行 Metadata Filtering(元数据过滤):限定企业、平台、适用范围、审核状态和有效版本。在允许的候选范围内,再进行相关性检索。Qdrant 的官方文档说明了如何通过 payload 条件筛选向量点,这类能力可用于实现业务字段过滤;实际权限策略仍需由应用服务强制执行。技术文档
检索层可以采用 Hybrid Search(混合检索),同时处理精确词与语义表达。
Embedding(向量嵌入) 将文本转为用于相似度检索的数值表示,有助于连接“公司资质文件”和“经营主体证明材料”这类不同说法。BM25 则用于关键词检索,适合寻找文件编号、平台专有名称和准确条款名称。两路结果可通过 RRF(倒数排名融合) 合并,避免直接比较不同检索器的原始分数。RRF 官方说明
合并后的候选片段再交给 Reranker(重排序模型),结合当前问题重新判断相关程度。重排序负责提高证据匹配度;版本、权限和适用范围仍然是前置条件,不能因为旧文件“语义更相似”就重新进入当前答案。
RAG 与结构化输出:把证据转成可办理的清单
RAG(Retrieval-Augmented Generation,检索增强生成) 将检索到的证据交给大模型,由模型组织答案。在本案例中,输入应包括本次申请条件、当前规则片段、候选材料信息和必要的历史反馈。
这些来源需要标明各自用途。当前有效要求用于判断本次材料准备;历史通过记录用于理解特定条件下的经验;聊天中的临时意见进入待确认项。来源之间出现冲突时,应把冲突位置和责任人列出来,而不是让模型自行选一个看起来更合理的说法。
输出采用 Structured Output(结构化输出),用 JSON Schema 定义字段、类型和允许的状态。示例结构如下:
{
  "application_id": "APP-DEMO-001",
  "status": "needs_confirmation",
  "requirements": [
    {
      "requirement_id": "REQ-DEMO-01",
      "candidate_document_id": "DOC-DEMO-02",
      "match_status": "pending_review",
      "evidence_chunk_ids": ["CHUNK-DEMO-03"],
      "reason": "候选材料名称不同,需核对内容与当前要求",
      "owner_role": "operations"
    }
  ],
  "next_action": "向平台确认候选材料是否满足本次申请要求"
}
结构校验只能说明输出格式符合约定。业务服务还需要检查证据 ID 是否真实存在、来源是否仍有效、用户是否有权访问,以及每条结论是否有相应依据。通过检查后,再把数据渲染成运营可使用的清单、法务待确认项和原文链接。
这一步对应 Grounding(证据约束) 与 Citation(来源引用):答案中的具体判断能够回到原文。RAG提供了基于资料回答的路径,答案是否正确仍需要通过证据核验和测试来判断。
上下文与记忆:保留本次任务,也沉淀可复用经验
Context(上下文) 是模型当前处理任务时实际拿到的信息,包括本次申请条件、已授权的证据片段、文件状态与待解决问题。知识库可以很大,但不应把全部资料一次塞入上下文。系统应围绕当前步骤按需取用,缺少条件时追问,进入核验阶段时再补充相关原文。
Memory(记忆) 则用于跨轮次、跨会话保留必要信息。在本案例中,已确认的平台、主体、经办人和未完成事项,应保存在任务数据库中。用户第二天继续办理时,系统读取这些记录,恢复工作状态,不必依赖模型记住上一段聊天。
任务记忆与长期知识需要分开管理。“本次申请使用某个文件版本”属于执行记录;“某类主体在某条件下适用某项要求”属于经过审核后可复用的知识。模型生成的摘要和一次提交成功,都不能直接覆盖正式规则。
这一区分使系统能够连续办事,也使业务经验有明确的入库路径:记录先进入复盘,由责任人判断哪些内容值得保留,再补充适用条件、证据和复核时间。
权限与工作流:让不同岗位接续完成任务
权限设计可以组合使用 RBAC(基于角色的访问控制) 与 ABAC(基于属性的访问控制)。RBAC区分运营、法务和资料管理员的职责;ABAC进一步结合所属企业、项目、资料敏感级别及当前任务条件进行判断。
权限校验应覆盖检索、父块补全、原件下载和结果缓存。未经授权的内容不能先送入模型,再靠提示词要求模型隐藏。若采用 PostgreSQL 保存业务记录,可结合 RLS(行级安全策略) 控制记录访问;服务账号、表所有者及具有绕过权限的角色仍需单独配置。PostgreSQL 官方说明
材料清单生成后,由 Workflow Orchestration(工作流编排) 驱动岗位接续。这个场景中的主要步骤相对明确,可以先使用固定流程:
提交申请条件 → 补齐信息 → 检索适用规则 → 生成材料清单
                                  ↓
                       发现冲突或缺项 → 分派确认任务
                                  ↓
                       人工确认 → 提交 → 记录平台反馈
需要专业判断的位置设置 Human-in-the-loop(人工参与节点)。状态由流程服务管理,例如“待补充、待核验、已确认、已提交、已退回、已完成”。模型提出建议,已确认和已提交等业务状态由实际操作触发。
如果后续引入 Agent(智能体),可以让它在授权工具范围内,根据缺项选择检索、读取或创建待办等动作。步骤稳定的主流程仍由工作流控制;是否需要智能体,取决于中间步骤是否确实需要动态判断。
MCP(模型上下文协议) 可以作为模型应用连接检索、文件或任务工具的一种接口方式。它解决工具如何被发现和调用,不负责保证资料正确,也不能替代业务权限。对简单的一期系统,直接调用内部API同样可以完成接入。MCP工具规范
接口调用还需要 Idempotency(幂等性):同一申请重试时,不应重复创建确认任务或重复提交。可以用申请编号、动作类型和版本组成幂等键,同时保留任务日志与重试记录。
更新与验收:验证整条链路能否持续工作
平台要求变化后,通过 Incremental Indexing(增量索引) 更新受影响文档及其片段。content_hash 用于发现内容变化,业务版本用于标记变更关系;新索引校验完成后,再切换当前可用版本,避免一份清单混用新旧要求。
已经失效的规则需要及时从当前检索范围移除。若新版本尚未完成处理,相关问题应转入待确认状态。历史版本继续留档,用于解释某次提交当时采用的依据。规则变更还应触发未完成申请的复核,形成 Event-driven Workflow(事件驱动工作流)。
技术验收与业务验收分别保留记录。检索层可以使用 Recall@K,观察标准证据是否进入前K个结果;回答层检查证据是否支持结论、引用是否准确、是否识别缺失条件;权限层测试跨企业、跨角色和原件下载等路径;性能层记录 P95响应时间、更新生效延迟与失败率。
业务侧则跟踪准备清单耗时、额外确认次数、退回原因和异常处理周期。建立 Golden Dataset(黄金测试集) 时,应覆盖正常申请、规则变更、文件同名异义、证据冲突和权限不足等情况,并将调试样本与验收样本分开,避免系统只对展示问题表现良好。
一期可采用“原件存储+元数据与任务数据库+混合检索+大模型生成+固定工作流”的架构。只有在跨主体、合同、授权范围等关系查询成为主要困难时,再评估 Knowledge Graph(知识图谱);只有在业务测试持续暴露术语匹配不足、且具备合适训练与评测数据时,再评估Embedding微调。
对直说科技而言,这一方案的交付重点是把技术组件连接到明确的业务产物:一份有依据的材料清单,一组能分派的确认任务,一条可追踪的提交记录,以及能够回流到知识库的处理结果。系统的价值,最终体现在这些产物能否被不同岗位持续使用。